Kāpēc lokālā AI ir nākotne?
Mākslīgā intelekta attīstība ir mainījusi veidu, kā mēs mijiedarbojamies ar tehnoloģijām. Lai gan lieli AI modeļi parasti darbojas mākoņos, arvien vairāk lietotāju vēlas palaist valodu modeļus (LLM) tieši savā datorā - privātuma un ātruma dēļ. Iedomājieties, ka varat izmantot jaudīgu AI asistentu, neizejot no mājām un neuzticot savus datus nevienam mākoņpakalpojumam. Lokālā AI nodrošina tieši to - pilnīgu kontroli pār datiem, zibensātrumu bez interneta kavējumiem un iespēju eksperimentēt ar dažādiem modeļiem. Tas ir īpaši svarīgi tiem, kam rūp privātums vai nepieciešams strādāt bez pastāvīga tīkla savienojuma. Turklāt tas ir arī ekonomiski izdevīgi ilgtermiņā, jo nav jāmaksā par abonementiem vai resursu izmantošanu.
16 GB VRAM - Saldais punkts lokālai AI
Lielākajai daļai AI valodu modeļu veiksmīgai darbībai grafiskajā kartē (GPU) ir nepieciešams pietiekami daudz video atmiņas jeb VRAM. 16 gigabaiti (GB) VRAM tiek uzskatīti par “saldo punktu”, kas ļauj efektīvi darbināt daudzus jaudīgus lokālos LLM modeļus bez nepieciešamības daļu datu pārvietot uz lēnāku sistēmas atmiņu. Tas nozīmē labāku veiktspēju un stabilāku pieredzi. Vēl pirms dažiem gadiem 16 GB VRAM bija dārgu karšu privilēģija, bet tagad tas kļuvis pieejams arī budžeta segmentā.
Duelis: AMD Radeon RX 9060 XT pret Nvidia GeForce RTX 5060 Ti
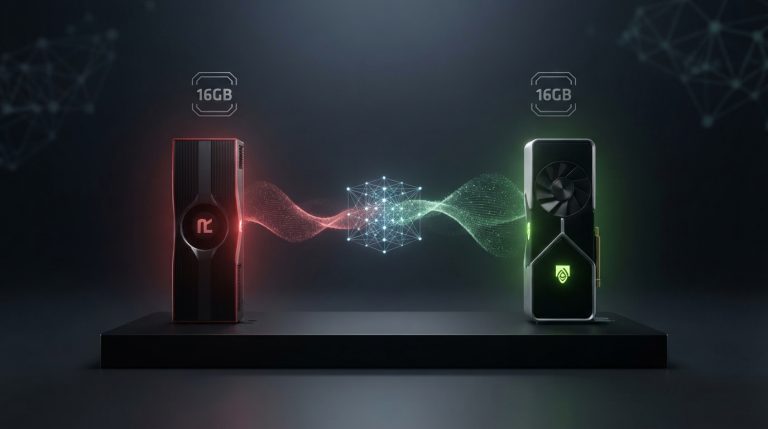
Šajā testā mēs aplūkojām divus budžeta segmenta gigantus ar 16 GB VRAM: AMD Radeon RX 9060 XT un Nvidia GeForce RTX 5060 Ti. Jau pirmajā acu uzmetienā pamanāma cenu atšķirība - AMD bāzes modelis pieejams no aptuveni 420 eiro, kamēr Nvidia starts ir ap 550 eiro. Mūsu testos izmantojām konkrētus, nedaudz dārgākus, bet reprezentatīvus modeļus:
- Sapphire Radeon RX 9060 XT 16GB NITRO+ Gaming OC (ap 470 eiro)
- MSI GeForce RTX 5060 Ti GAMING OC 16G (ap 690 eiro)
Šie modeļi ir optimizēti ar labāku dzesēšanu un rūpnīcas paātrinājumu, taču to veiktspēja ir pielīdzināma attiecīgajiem bāzes modeļiem.
Testēšanas metodika: Ollama un LLM izaicinājumi
Lai salīdzinātu karšu veiktspēju, izmantojām populāro atvērtā koda programmatūru Ollama, kas ļauj viegli palaist dažādus LLM modeļus uz parastas patērētāju aparatūras. Testi tika veikti divās operētājsistēmās - gan uz Windows 11, gan uz Ubuntu 26.04 (Linux), lai iegūtu visaptverošu ainu. Mēs “izaicinājām” kartes ar gariem jautājumiem, izmantojot trīs dažādus LLM modeļus:
- GPT-OSS un Qwen3.5: Abi modeļi pilnībā ietilpst 16 GB VRAM.
- Qwen3.6: Šis modelis ir aptuveni par 10 GB lielāks nekā pieejamais VRAM, tāpēc atlikusī daļa tika ielādēta sistēmas RAM. Tomēr Qwen3.6 ir “Mixture-of-Experts” (MoE) arhitektūras modelis. Tas nozīmē, ka modeļa darbībai tiek izmantotas tikai vispiemērotākās tā daļas (“eksperti”), padarot to efektīvāku pat ar ierobežotu VRAM un sistēmas atmiņas palīdzību.
Rezultāti un secinājumi: Vai dārgāk vienmēr labāk?
Kopumā AMD Radeon RX 9060 XT nodrošināja pilnīgi pieņemamus rezultātus lokālajai AI apstrādei, īpaši modeļiem, kas pilnībā ietilpa VRAM. Tomēr, salīdzinot ar Nvidia GeForce RTX 5060 Ti, pēdējā parādīja nedaudz labāku veiktspēju, īpaši sarežģītākos uzdevumos un ar lielākiem modeļiem kā Qwen3.6, kur daļa modeļa atrodas sistēmas atmiņā. Nvidia kartes efektivitāte un saderība ar AI rīkiem joprojām dod tai nelielu priekšrocību, taču AMD ir ievērojami pietuvojusies. Izvēle ir atkarīga no jūsu budžeta un prioritātēm. Ja katrs eiro ir svarīgs un esat gatavs pieņemt nelielu veiktspējas kompromisu, AMD ir lieliska izvēle.
Tā kā AI tehnoloģijas turpina attīstīties, lokālo AI iespējas tikai pieaugs. Kurā nometnē Tu esi - AMD vai Nvidia? Un vai lokālā AI ir jau daļa no Tavas digitālās ikdienas?
Iezīmē tekstu un spied ziņot par kļūdu.